


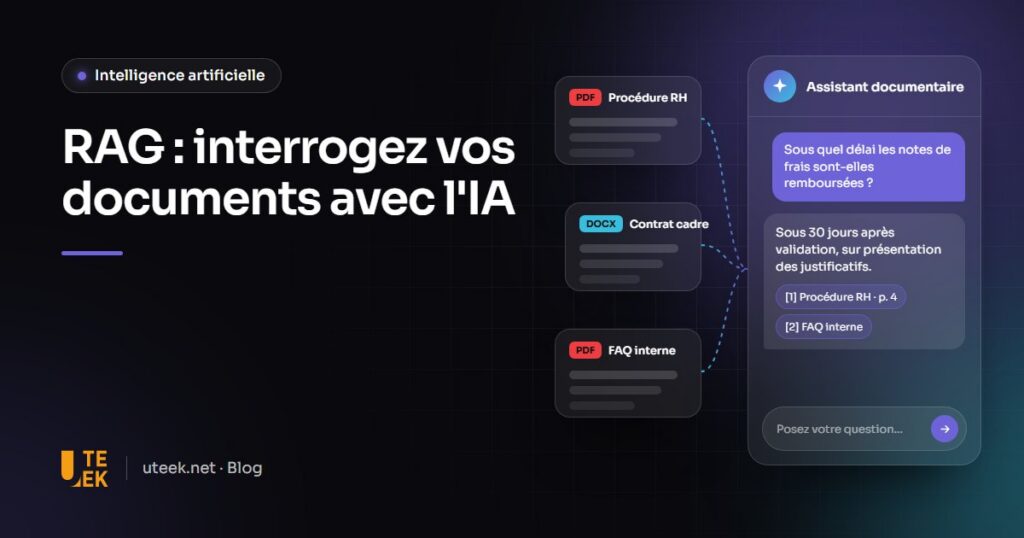
Le RAG en entreprise (Retrieval-Augmented Generation, ou génération augmentée par la recherche) permet d’interroger vos documents internes en langage naturel : un assistant d’IA retrouve les passages pertinents dans vos procédures, contrats ou manuels, puis rédige une réponse qui cite ses sources. Il répond à partir de vos textes et non de mémoire, ce qui limite les inventions et évite tout réentraînement quand un document change. Bien conçu, il respecte les droits d’accès de chacun et sait dire « je ne sais pas ».
En bref
- Le RAG associe une recherche dans vos documents à un modèle de langage qui rédige une réponse sourcée.
- Il convient aux procédures, politiques RH, documentations techniques, contrats et bases de connaissances.
- La fiabilité repose sur les citations, des questions de test et des documents à jour.
- La sécurité passe par les droits d’accès, le choix de l’hébergement et la prévention de l’injection de prompt.
Qu’est-ce que le RAG en intelligence artificielle ?
Le terme vient d’un article de recherche de Patrick Lewis et ses coauteurs, présenté à la conférence NeurIPS 2020. Le principe : compléter la mémoire d’un modèle de langage par une source externe consultée à chaque question, à l’époque un index de passages de Wikipédia.
En entreprise, cette source, ce sont vos documents : pour mettre l’assistant à jour, il suffit de mettre à jour les documents.
Comment fonctionne le RAG, étape par étape ?
- Collecter et convertir : les documents (serveur de fichiers, GED, espace cloud, intranet) sont convertis en texte, avec une reconnaissance de caractères (OCR) pour les scans.
- Découper en passages : chaque document est divisé en extraits de quelques paragraphes, qui gardent leur titre et leur source.
- Créer les embeddings et l’index vectoriel : chaque passage devient un vecteur, une suite de nombres qui représente son sens, stocké dans un index.
- Retrouver les passages pertinents : l’index renvoie les passages les plus proches de la question par le sens, même formulés autrement.
- Générer une réponse sourcée : le modèle reçoit la question et ces passages, puis rédige une réponse qui cite ses sources.
Quels documents internes peut-on interroger ?
- Procédures et politiques RH : « Combien de jours de congé après deux ans ? » obtient une réponse et le lien vers la note concernée.
- Documentation qualité et technique : modes opératoires, fiches techniques, manuels de maintenance.
- Contrats et appels d’offres : retrouver une clause, comparer des conditions, vérifier les exigences d’un cahier des charges.
- Base de connaissances du support : les conseillers trouvent la bonne procédure sans parcourir des dizaines de fiches.
- Intégration des nouveaux collaborateurs : des réponses immédiates, sans mobiliser un collègue.
RAG, moteur de recherche, chatbot ou fine-tuning : quelle différence ?
| Approche | Ce qu’elle fait | Fraîcheur des données | Sources citées | Coût et effort |
|---|---|---|---|---|
| Moteur de recherche classique | Liste les documents contenant vos mots-clés | À jour dès l’indexation | Oui, les documents eux-mêmes | Faible, souvent déjà en place |
| Chatbot généraliste | Répond avec ses connaissances générales | Figée à l’entraînement, sauf recherche web | Variable, pas vos documents internes | Faible, mais sans accès à vos documents |
| RAG | Rédige une réponse à partir des passages retrouvés dans vos documents | À jour dès la réindexation | Oui, passage par passage | Modéré : préparation, intégration, tests |
| Fine-tuning | Ajuste le modèle sur vos exemples | Figée à l’entraînement | Non | Élevé, à refaire pour intégrer du nouveau |
Le RAG et le fine-tuning peuvent se combiner : l’un pour les informations qui évoluent, l’autre pour le style.
Comment rendre les réponses fiables ?
- Citer les sources : chaque réponse renvoie aux passages utilisés.
- Savoir dire « je ne sais pas » : l’assistant ne répond qu’à partir des passages retrouvés et le signale quand ils sont insuffisants.
- Évaluer avec des questions de test : une cinquantaine de questions réelles avec leur réponse attendue, rédigées par les experts métier et rejouées après chaque modification.
- Tenir les documents à jour : un responsable par document, des versions obsolètes retirées, une réindexation automatique.
Comment protéger vos données confidentielles ?
Respecter les droits d’accès existants
L’assistant ne doit retrouver que les documents que l’utilisateur peut déjà consulter : les droits sont appliqués pendant la recherche, avant que le modèle ne reçoive quoi que ce soit. Sinon, une question anodine pourrait faire apparaître une grille de salaires.
Choisir l’hébergement
- Fournisseur cloud avec garanties contractuelles : pas d’entraînement sur vos données, conservation et localisation précisées au contrat.
- Hébergement dans l’Union européenne ou sur site : pour les données sensibles.
- Modèles open source : installés chez vous, sans transmission externe, mais avec des serveurs à gérer.
Prévenir l’injection de prompt
Un document peut cacher des instructions : l’OWASP cite un CV dont le texte blanc sur fond blanc demande de recommander le candidat. Son Top 10 pour les applications LLM place l’injection de prompt en tête et consacre une entrée aux faiblesses des vecteurs et embeddings. Indexez des sources maîtrisées et limitez l’assistant à la lecture.
Encadrer les journaux
Les questions posées peuvent contenir des données personnelles : limitez l’accès aux journaux et leur conservation, conformément à la loi tunisienne et, s’il s’applique, au RGPD.
Comment lancer un projet pilote ?
- Choisir un cas d’usage et un corpus : une question fréquente, des documents délimités, une équipe pilote.
- Nettoyer les documents : doublons, versions obsolètes, scans illisibles.
- Construire l’assistant : connecteurs, index, droits d’accès, interface.
- Tester avec de vrais utilisateurs et les questions de test.
- Mesurer : réponses exactes, sources correctes, questions sans réponse, temps gagné.
- Étendre à d’autres documents ou équipes si les résultats sont au rendez-vous.
Qu’est-ce qui fait varier le coût d’un projet RAG ?
Les principaux postes : volume et état des documents, nombre de sources à connecter, finesse des droits d’accès, API facturée à l’usage ou serveurs dédiés, volume de questions et suivi dans la durée. Un pilote permet de les estimer avant de généraliser.
FAQ
Le RAG empêche-t-il l’IA d’inventer des réponses ?
Il réduit ce risque sans le supprimer, car le modèle peut encore mal interpréter un passage. Les citations permettent de vérifier chaque réponse, et les questions de test mesurent le taux d’erreur réel.
Faut-il réentraîner le modèle quand un document change ?
Non. Il suffit de réindexer le document modifié, ce qui peut être automatisé. C’est l’un des principaux avantages du RAG sur le fine-tuning.
Quels formats de documents peut-on interroger ?
Les PDF, documents Word, tableurs, présentations et pages d’intranet se traitent bien. Les scans passent par l’OCR, dont la qualité doit être contrôlée.
Nos documents confidentiels sont-ils envoyés à un tiers ?
Cela dépend de l’architecture. Avec un modèle accessible par API, tout ou partie de vos documents est transmis au fournisseur : exigez des garanties contractuelles. Pour les documents les plus sensibles, un modèle open source hébergé sur vos serveurs évite toute transmission externe.
Interroger vos documents avec Uteek
L’équipe IA d’Uteek, agence digitale basée aux Berges du Lac 2, à Tunis, conçoit et intègre des assistants RAG connectés à vos documents et à vos outils, du choix du corpus à l’hébergement. Découvrez notre offre d’intelligence artificielle ou présentez-nous votre projet.
Articles similaires
Agents IA en entreprise : définition, cas d’usage et méthode pour automatiser sans risque
Trier les e-mails, qualifier les prospects, préparer des devis… Les agents IA ne se contentent plus de répondre,…
Intelligence artificielle en entreprise : 7 cas d’usage concrets pour les PME
Assistant client, lecture automatique de factures, prévision des ventes… L'IA n'est plus réservée aux grands groupes. 7 cas…
Chatbot IA pour site web : fonctionnement, intégration et limites
Un chatbot IA bien conçu répond 24 h/24 à partir de vos propres contenus et passe la main…